
Jeszcze niedawno „lokalna sztuczna inteligencja” oznaczała przede wszystkim niewielki model uruchomiony na mocnym komputerze. Większe modele pozostawały domeną centrów danych, serwerów wyposażonych w kosztowne akceleratory i usług chmurowych.
NVIDIA chce tę granicę przesunąć bardzo daleko.
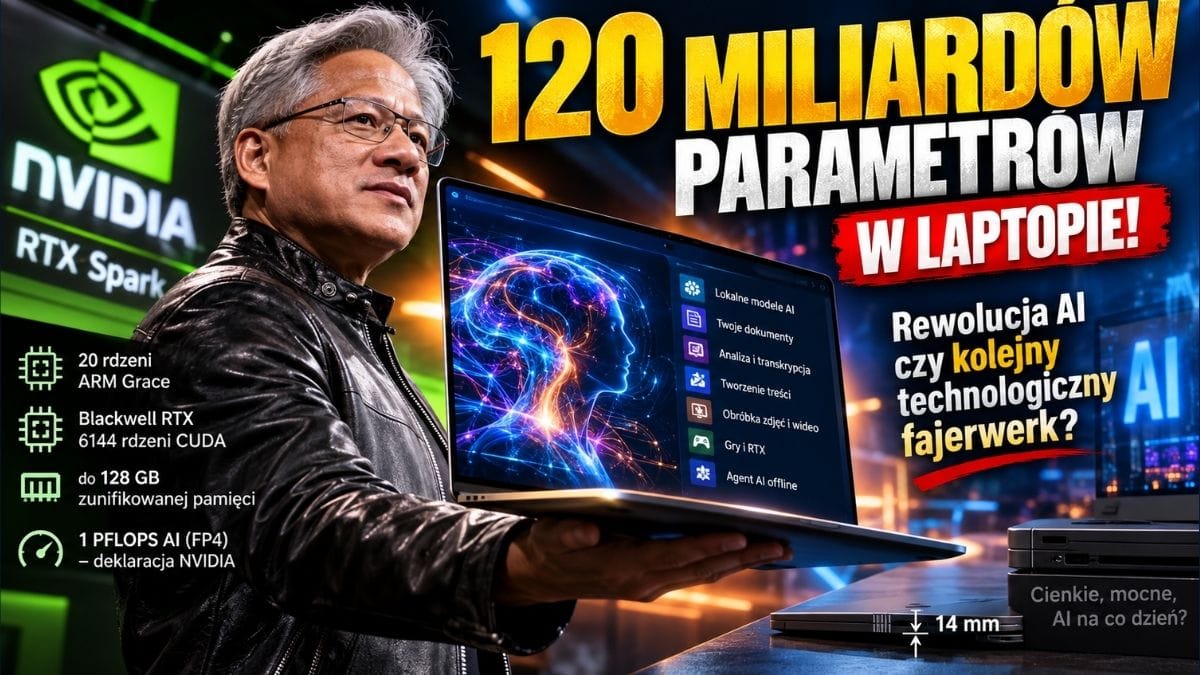
Zapowiedziany RTX Spark ma trafić do pierwszych komputerów z Windows już w październiku 2026 roku. Najmocniejsza konfiguracja łączy 20-rdzeniowy procesor Grace oparty na ARM, zintegrowany układ graficzny Blackwell RTX i nawet 128 GB pamięci współdzielonej przez CPU oraz GPU. NVIDIA mówi o maksymalnie 1 PFLOPS wydajności AI FP4 oraz możliwości lokalnego uruchamiania ogromnych modeli językowych.
Brzmi jak koniec chmury i początek „AI we własnym komputerze”.
Tyle że między prezentacją Jensena Huanga a komputerem stojącym na naszym biurku znajduje się jeszcze sporo gwiazdek.
120B bez internetu. To nie jest już science fiction
Najbardziej spektakularną deklaracją jest możliwość lokalnej pracy modeli mających 120 miliardów parametrów.
To właśnie tutaj 128 GB zunifikowanej pamięci może mieć większe znaczenie niż efektownie wyglądający „petaflop”. NVIDIA podaje dla platformy przepustowość pamięci sięgającą około 300 GB/s. CPU i GPU korzystają ze wspólnej, spójnej przestrzeni pamięci, zamiast klasycznego podziału na RAM komputera i osobny VRAM karty graficznej. NVIDIA Docs
Dla AI to zasadnicza różnica.
W dzisiejszym komputerze możemy mieć 64 czy 128 GB RAM, ale potężny model AI i tak może rozbić się o kilkanaście lub 24 GB pamięci znajdującej się na karcie graficznej. RTX Spark próbuje usunąć właśnie tę barierę.
Nagle komputer osobisty może nie tylko wysłać nasze pytanie do modelu znajdującego się gdzieś w centrum danych. Sam może stać się miejscem, w którym model pracuje.
To nie jest jedynie zmiana techniczna.
To potencjalna zmiana modelu korzystania ze sztucznej inteligencji.
Ale „uruchamia 120B” nie oznacza jeszcze „świetnie obsługuje 120B”
W tym miejscu marketing trzeba oddzielić od praktyki.
Model można:
zmieścić w pamięci, uruchomić i komfortowo używać.
To trzy różne rzeczy.
Dla użytkownika znacznie ważniejszą liczbą od 120 miliardów parametrów będzie więc liczba tokenów generowanych na sekundę. Jeżeli odpowiedź dużego modelu będzie pojawiała się bardzo wolno, imponująca demonstracja techniczna niekoniecznie zamieni się w wygodne narzędzie codziennej pracy.
Podobnie należy traktować deklarowany 1 PFLOPS. NVIDIA mówi tutaj o obliczeniach AI FP4, czyli niskiej precyzji wykorzystywanej w określonych operacjach sztucznej inteligencji. Nie można tej liczby porównywać jeden do jednego z klasycznymi wynikami FP32 GPU.
Petaflop świetnie wygląda na slajdzie.
Użytkownika bardziej powinno interesować: ile sekund będę czekał na odpowiedź?
To nie jest zwyczajny laptop z GeForce’em
I właśnie tutaj zaczyna się naprawdę interesująca część historii.
RTX Spark jest platformą ARM, a nie kolejnym procesorem x86 Intela lub AMD z dołączonym GeForce’em. Najmocniejsza odmiana wykorzystuje 20 rdzeni ARM v9.2 — 10 wydajnościowych Cortex-X925 oraz 10 energooszczędnych Cortex-A725 — i zintegrowaną grafikę Blackwell. NVIDIA Docs
NVIDIA próbuje więc zrobić z komputerem Windows coś podobnego do tego, co Apple zrobiło, przechodząc na Apple Silicon: znacznie ściślej połączyć poszczególne elementy platformy.
Tyle że NVIDIA dorzuca do tego własne potężne atuty: CUDA, Blackwell, RTX i cały ekosystem AI.
Dlatego stwierdzenie krążące w mediach społecznościowych, że NVIDIA właśnie „zakończyła 30-letnią historię tradycyjnego PC”, jest zdecydowanie przedwczesne.
Ale pytanie, czy właśnie zaczyna się kolejny etap tej historii, jest już całkiem zasadne.
A co z naszymi obecnymi programami?
Tu pojawia się pierwsza bardzo praktyczna przestroga dla potencjalnego nabywcy.
Windows na ARM potrafi uruchamiać aplikacje x86 i x64 przez emulację. NVIDIA sama wskazuje jednak, że zgodność zależy od konkretnego programu i jego komponentów. Najlepszą wydajność oraz efektywność energetyczną mają zapewniać aplikacje natywne ARM. NVIDIA Docs
Jeszcze ważniejsze są sterowniki.
NVIDIA wyraźnie zaznacza, że sterowników x86/x64 działających w trybie jądra nie można uruchamiać w Windows ARM. Producent urządzenia musi dostarczyć wersję ARM64. NVIDIA Docs
Dla przeciętnego użytkownika drukarki może to nie mieć większego znaczenia.
Dla fotografa, muzyka, realizatora dźwięku, montażysty, firmy korzystającej ze specjalistycznego sprzętu albo kogoś posiadającego starsze urządzenia USB już może.
Dlatego przed zakupem pierwszego RTX Spark należałoby sprawdzić nie tylko:
„Czy mój program działa?”
ale również:
„Czy działa mój interfejs audio, karta przechwytująca, urządzenie pomiarowe, skaner, kontroler i wszystkie potrzebne mi sterowniki?”
Pierwsi nabywcy będą w pewnym sensie również testerami nowego ekosystemu.
Największa rewolucja może jednak nie dotyczyć gier
NVIDIA oczywiście promuje także gry. RTX, DLSS, Blackwell i cały gamingowy ekosystem pozostają ważną częścią projektu.
Ale patrzenie na RTX Spark wyłącznie jako na nowego laptopa gamingowego byłoby przeoczeniem znacznie ciekawszego zjawiska.
Wyobraźmy sobie komputer, który lokalnie:
transkrybuje wielogodzinne nagrania, analizuje tysiące dokumentów, przeszukuje prywatne archiwum, indeksuje pocztę, rozpoznaje obrazy, streszcza dokumentację, tworzy lokalną bazę wiedzy, wykonuje zadania programistyczne i obsługuje agenta AI.
Bez konieczności wysyłania każdego dokumentu na zewnętrzny serwer.
To może być bardzo istotne dla przedsiębiorstw, kancelarii, redakcji, twórców, programistów, administracji czy osób pracujących z poufnymi materiałami.
AI wraca z chmury do domu
I tutaj dochodzimy do aspektu, który może okazać się ważniejszy od wszystkich benchmarków.
Dziś większość zaawansowanej sztucznej inteligencji działa według prostego schematu:
nasz komputer → internet → centrum danych → model AI → internet → nasz komputer.
RTX Spark rozwija alternatywny model:
nasz komputer → nasz model → nasze dane → odpowiedź.
Po pobraniu modelu część takich zastosowań może działać bez dostępu do internetu.
To oznacza potencjalnie mniejsze uzależnienie od abonamentu, API, limitów wykorzystania oraz zewnętrznych serwerów. Jednocześnie dane mogą pozostać na urządzeniu.
Samo hasło „AI lokalnie” nie oznacza jednak automatycznie pełnego bezpieczeństwa.
Agent mający dostęp do naszych dokumentów, przeglądarki, aplikacji i systemu operacyjnego może być niezwykle użyteczny. Może być również niezwykle niebezpieczny, jeżeli otrzyma zbyt szerokie uprawnienia albo zostanie zmanipulowany przez złośliwą treść.
Paradoks następnej generacji komputerów może więc brzmieć:
Nie musimy już wysyłać swoich danych do AI w chmurze. W zamian wpuszczamy AI bezpośrednio do swoich danych.
I właśnie dlatego bezpieczeństwo lokalnych agentów będzie równie istotne jak ich inteligencja.
Jeden komputer to dopiero początek
Jeszcze ciekawiej robi się za sprawą technologii NVIDIA PAIR — Personal AI Router.
PAIR ma pozwalać połączyć kompatybilne komputery znajdujące się w lokalnej sieci i kierować pomiędzy nie zadania inferencji. Obsługiwane mają być m.in. komputery RTX, DGX Spark oraz urządzenia Apple z układami M4 i nowszymi. Prompty, pliki i kontekst mogą pozostawać w lokalnej sieci. NVIDIA Developer
Trzeba przy tym sprostować potencjalne nieporozumienie: PAIR nie zamienia kilku komputerów w jeden gigantyczny wirtualny GPU. Poszczególne maszyny pozostają oddzielnymi systemami i równolegle wykonują przydzielone im zadania. NVIDIA
Ale rezultaty demonstracyjne są interesujące.
NVIDIA podaje przykład pracy pięciu subagentów: trzy urządzenia połączone przez PAIR ukończyły zadanie w 8 minut i 48 sekund, podczas gdy pojedynczy laptop RTX Spark potrzebował 18 minut. To wynik demonstracji producenta, a nie niezależny benchmark, lecz dobrze pokazuje ideę. NVIDIA Developer
W przyszłości małe biuro może więc mieć własną „chmurę AI”, która tak naprawdę… nigdy nie opuszcza biura.
I tu pojawia się ekonomia
To będzie jeden z najważniejszych testów całej koncepcji.
Chmura ma ogromną zaletę: płacimy za wykorzystanie i nie musimy kupować potężnego komputera.
Lokalne AI odwraca tę relację.
Najpierw kupujemy sprzęt, zużywamy energię i sami odpowiadamy za jego utrzymanie, ale później możemy wykonywać ogromną liczbę operacji bez płacenia za każdy milion tokenów.
Dla osoby pytającej AI kilka razy dziennie własny potężny komputer może ekonomicznie nie mieć większego sensu.
Dla firmy wykonującej miliony lokalnych operacji, programisty, laboratorium, twórcy albo redakcji przetwarzającej codziennie setki dokumentów rachunek może wyglądać zupełnie inaczej.
Dlatego jednym z najważniejszych parametrów RTX Spark będzie coś, czego marketingowy post ze zdjęcia właściwie nie porusza:
cena.
Dopiero zestawienie ceny komputera, poboru energii, rzeczywistej wydajności i kosztu analogicznej pracy wykonywanej przez API pokaże ekonomiczny sens lokalnego AI.
Czy oznacza to koniec ChatGPT i innych usług chmurowych?
Nie.
Przynajmniej nie na podstawie tego, co wiemy dzisiaj.
Największe modele działające w centrach danych nadal dysponują zasobami, których laptop nie jest w stanie odtworzyć. Usługi chmurowe mogą również korzystać z aktualnych informacji, specjalistycznych narzędzi i ogromnej infrastruktury.
Bardziej prawdopodobny wydaje się więc model hybrydowy.
Proste, prywatne i masowe operacje wykonywane są lokalnie. Trudniejsze zadania trafiają do większego modelu w chmurze.
To może być odpowiednik tego, co od dawna dzieje się z innymi usługami komputerowymi: część wykonujemy na urządzeniu, część na serwerze.
Tyle że teraz przedmiotem tego podziału będzie inteligencja.
NVIDIA buduje coś więcej niż procesor
Warto również zauważyć, że producent nie pozostawia użytkownika z samym układem scalonym.
NVIDIA poinformowała we wrześniu o optymalizacjach llama.cpp i vLLM, które mają dawać do 1,9 raza szybszą lokalną inferencję. Rozwiązania mają być dostępne także przez popularne środowiska LM Studio i Ollama. Firma rozwija również PAIR i narzędzia przeznaczone dla lokalnych agentów. NVIDIA Blog
To ważna wskazówka.
Produktem nie ma być tylko RTX Spark. Produktem ma być lokalny ekosystem AI.
Sprzęt jest jego fundamentem.
Co zatem powinien zrobić zwykły użytkownik?
Przede wszystkim — nie wyrzucać jeszcze swojego komputera przez okno.
NVIDIA przedstawiła bardzo interesującą architekturę, ale jej prawdziwy egzamin rozpocznie się dopiero wtedy, kiedy seryjne urządzenia trafią do użytkowników.
Jeżeli ktoś kupuje komputer przede wszystkim do internetu, pakietu biurowego, oglądania filmów i okazjonalnego korzystania z ChatGPT, 128 GB zunifikowanej pamięci dla lokalnego AI może być rozwiązaniem imponującym, ale zupełnie niepotrzebnym.
Jeżeli natomiast ktoś pracuje z AI, programowaniem, grafiką, montażem, dużymi zbiorami dokumentów albo poufnymi danymi, RTX Spark jest platformą, którą zdecydowanie warto obserwować.
Przed zakupem należałoby jednak poczekać na pięć liczb:
cenę, rzeczywistą wydajność modeli 30B/70B/120B, pobór energii, czas pracy na baterii i temperatury pod długotrwałym obciążeniem.
Do tego dochodzi szóste pytanie: kompatybilność własnego oprogramowania i urządzeń z Windows ARM.
A więc rewolucja czy marketing?
Na 30 września 2026 roku odpowiedź brzmi: technologia jest realna, rewolucja jeszcze wymaga dowodu.
RTX Spark nie jest internetowym fejkiem. NVIDIA rzeczywiście stworzyła platformę ARM z grafiką Blackwell, do 128 GB zunifikowanej pamięci i sprzętem zaprojektowanym między innymi z myślą o dużych lokalnych modelach AI. Pierwsze nowe komputery RTX Spark z Windows firma zapowiada na październik. NVIDIA Blog
Nie oznacza to jednak, że klasyczny PC umarł, chmura przestała być potrzebna albo każdy model 120B będzie śmigał na laptopie niczym kalkulator.
Znacznie ważniejsze może być coś mniej widowiskowego.
Przez ostatnich kilka lat przyzwyczajaliśmy się, że AI jest usługą, do której się łączymy.
RTX Spark reprezentuje zupełnie inną wizję:
AI może być częścią komputera, który posiadamy.
Jeżeli ta koncepcja się przyjmie, pytanie za kilka lat może już nie brzmieć: „Z jakiej sztucznej inteligencji korzystasz?”.
Może brzmieć:
„Jaką sztuczną inteligencję masz u siebie?”
I wtedy dopiero okaże się, czy oglądaliśmy kolejną efektowną prezentację nowego procesora, czy jeden z momentów, w których komputer osobisty po raz kolejny zmienił znaczenie słowa „osobisty”.
Czytaj dalej
Ten temat ma ciąg dalszy
Wybraliśmy teksty, które naturalnie prowadzą czytelnika dalej.